Skip to content
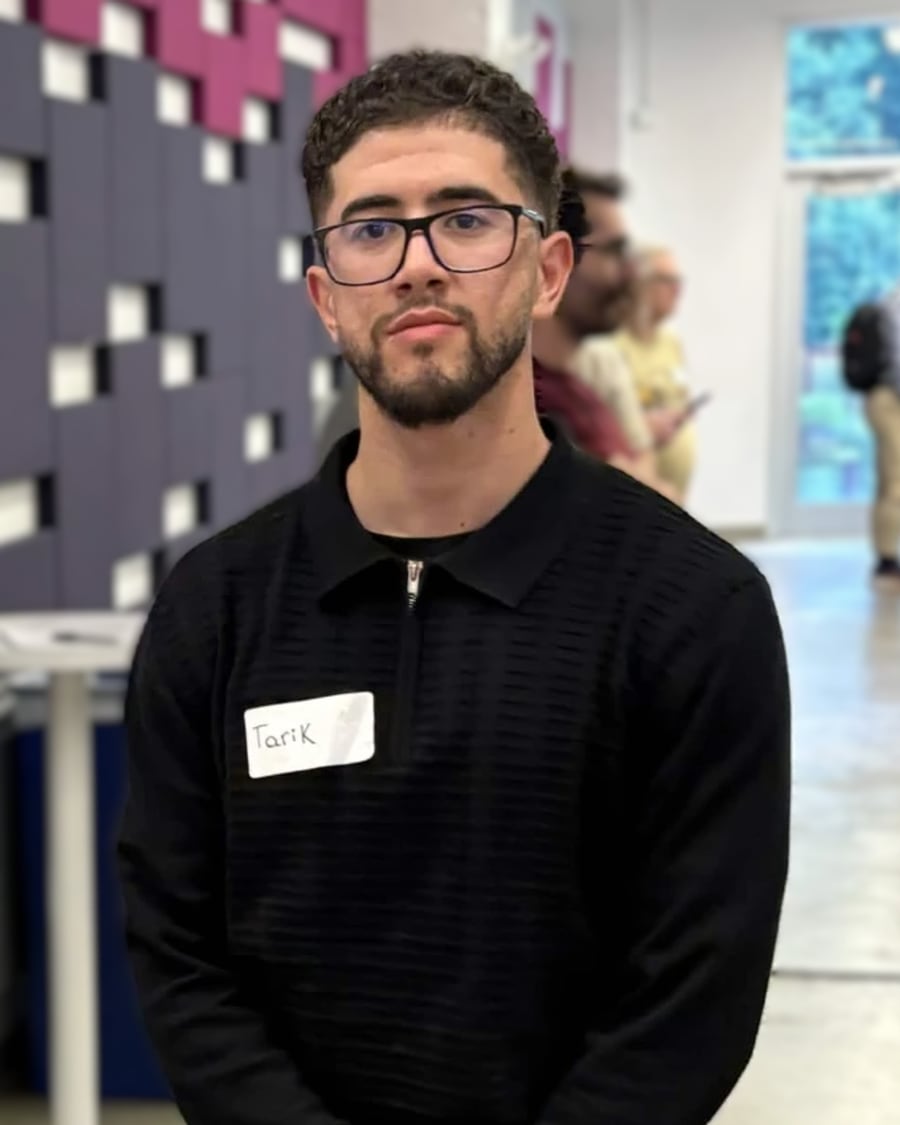
Portrait de Tarik Hireche

Développeur logiciel bilingue

Tarik Hireche

J'aime travailler sur la couche sous l'application, là où vivent les processus, les conteneurs et les pipelines. Ce que j'en sais, je l'ai surtout appris en construisant quelque chose puis en le démontant.

  • Java
  • C#
  • SQL
  • Infonuagique et infrastructure
Diplôme
B.Sc. Informatique · Université de Montréal (DIRO)
Domaine
Services JVM, conteneurs, CI
Diplôme
B.Sc. Informatique, UdeM
Point fort
Java · C# · SQL · Infonuagique et infrastructure
Basé à
Montréal, QC
Langues
Anglais · Français · Arabe

Expérience

  1. Mars 2026 à aujourd'hui

    Développeur logiciel

    J'ai sorti le site du client de WordPress vers une plateforme de contenu en PHP que j'ai écrite pour lui. Elle gère les téléversements, tient un journal d'activité en ajout seul et un historique de version par document, donc un changement se retrace après coup. Compresser les images côté serveur a retiré 45 % du poids des pages. Je suis la seule personne technique là-bas, donc les déploiements et les mises en ligne sont à moi aussi, et j'ai écrit les étapes pour qu'ils arrêtent de m'appeler pour les changements de routine. L'automatisation de l'infolettre est sortie de ce travail : Python et JavaScript pour trois langues, ce qui a ramené une tâche d'une à trois heures à une trentaine de minutes sur plus de dix campagnes.

  2. Mai 2022 à février 2024

    Gatestone

    Montréal, QC

    Agent de soutien technique

    Je diagnostiquais des problèmes de connectivité et de compte pour des clients entreprises, sous pression de temps. Chaque appel commençait par une vérification d'identité avant que je puisse toucher à des données sensibles.

Projets choisis

5 projets

Trois sur lesquels j'aimerais qu'on me pose des questions, puis les autres. L'un d'eux tourne en direct dans cette page.

uiResidentMenu · IntervenantMenuOpenDataSourceinterfaceMontrealOpenDataHTTP · CKANJSON fixtures35 offline testsdonnees.montreal.ca
The seam the refactor introduced: the console screens depend on an OpenDataSource interface. MontrealOpenData implements it over HTTP against the city's CKAN portal; the tests implement it from JSON fixtures, so the suite runs offline.

Application Java

2026

Ma Ville

Une application Java qui permet aux résidents de Montréal de voir les travaux en cours dans leur rue, et aux intervenants de trouver les demandes déposées et d'y soumissionner.

La ville publie tout ça en données ouvertes, et rien n'est lisible par un humain. J'ai pris un projet d'équipe qui fonctionnait et j'en ai fait quelque chose qu'un autre développeur peut reprendre.

  • Passage du projet à Maven pour qu'un clone neuf compile. Avant ça, il ne compilait que dans les IDE où on l'avait écrit.
  • Découpe de deux très grosses classes en plus petites : Resident.java de 780 lignes à 106, et Menu.java de 579 à 97.
  • 6 bogues trouvés et corrigés en retirant du code dupliqué, et la suite de tests passée de 9 à 35.
  • Java 17
  • Maven
  • JUnit 4
  • Gson
  • REST / JSON
  • Données ouvertes de Montréal
Ce qu'a révélé la découpe d'une classe de 780 lignes
Resident.java
780 → 106 lignes

Les écrans, un client HTTP, l'analyse JSON et les lectures au clavier en sont sortis. Il reste les sept champs d'une personne et les deux opérations qui lui appartiennent.

Menu.java
579 → 97 lignes

Les deux écrans de connexion, les deux écrans d'inscription, les deux menus principaux et cinq validateurs de saisie en sont sortis. La classe choisit maintenant entre se connecter et s'inscrire.

Suite de tests
9 → 35 tests

Sur 6 fichiers, contre 3. L'ancienne suite avait besoin d'une API tierce en direct pour passer ; mvn test n'a plus besoin ni de réseau ni de terminal.

Bogues de duplication trouvés
6

Chacun est apparu en fusionnant des copies du même code. Ils sont listés dans le commit qui les a supprimés.

On était trois à construire ça pour un cours et ça marchait très bien sur nos machines. C'était justement le problème. JUnit et Hamcrest étaient versionnés en fichiers jar, et Gson passait par un réglage IntelliJ qui pointait vers un dossier sur le portable de quelqu'un. N'importe qui d'autre qui clonait obtenait un mur d'erreurs. Passer à Maven a été la première chose que j'ai faite.

La partie que j'ai trouvée la plus intéressante, c'est la découpe de Resident.java. 780 lignes qui faisaient environ cinq métiers à la fois : garder les informations d'une personne, dessiner les écrans, appeler l'API de la ville, analyser le JSON et lire le clavier. J'ai sorti le réseau et l'analyse dans leur propre paquet, et les écrans dans un autre. Ça a fait remonter un bogue que j'aime bien : la liste des dix types de travaux existait en trois copies séparées qui avaient divergé, donc l'option 8 affichait « Travaux résidentiel » sur un écran et « Travaux résidentiels » sur un autre. Un résident pouvait déposer une requête et ne jamais la retrouver. C'est une seule énumération maintenant, avec un test qui échoue si les libellés cessent de concorder.

La plupart des bogues que j'ai trouvés venaient de la même cause : la même logique écrite plus d'une fois. L'autre chose que j'en retiens, c'est que séparer le code qui va chercher du code qui analyse est ce qui a permis aux tests de tourner sans réseau. L'ancienne suite avait un test qui appelait l'API de la ville en direct, donc la compilation échouait sur toute machine qui ne pouvait pas l'atteindre.

watcher repoprivate · scheduledETag · 304job boards421 trackeddedupe · score 0-100 · work-auth parsereasons kept on every scoredata repopublic · jobs + healthCORSdashboardstatic Reactno server between the sweep and the browserfreshness published, so a dead sweep is visible
Four stages. A private scheduled repository holds the schedule and the filters and runs the sweep. The sweep fetches job boards with ETags, then deduplicates, scores and parses work authorization. It writes JSON to a separate public data repository. A static React dashboard reads that JSON in the browser over CORS, with no server in the path.

Automatisation et pipeline de données

2026

Job Watcher

Un outil qui parcourt des centaines de sites d'offres sur planification, classe ce qu'il trouve selon mon profil, et l'affiche sur une page qui ne coûte rien à faire tourner.

Les bons postes ferment en quelques jours. Éplucher un mur de sites à la main chaque matin, c'est une corvée, et les corvées finissent par sauter. On apprend qu'un poste existait une semaine après sa fermeture.

  • Implémentation faite en bonne partie avec de l'aide de l'IA. J'ai écrit les specs et le format JSON que les pièces se partagent, puis j'ai relu, testé et débogué ce qui revenait.
  • Monté en trois parties : un dépôt privé fait tourner la planification, un dépôt public garde le JSON produit, et une page statique le lit dans le navigateur. Rien ne tourne sur un serveur.
  • Suit actuellement 421 sites et affiche 442 offres notées sur 268 entreprises, avec les raisons de chaque note gardées à côté.
  • Conception de systèmes
  • Automatisation planifiée
  • GitHub Actions
  • Contrats de données JSON
  • Cache ETag
  • CORS
  • TypeScript
  • React
Le pipeline, le contrat, et qui a décidé quoi
Sites suivis
421

boards_known dans le health.json que le balayage publie en direct. Allez le lire, le dépôt de données est public.

Offres dans le flux actuel
442

Réparties sur 268 entreprises distinctes, après déduplication, notées et classées. Comptées depuis le jobs.json en direct.

Offres balayées en amont
3 331

last_count du dernier balayage. Récupérées avec un ETag, donc une source inchangée coûte un 304 et aucune analyse.

Rafraîchissement du tableau
120 s

La page relit le flux sur minuterie. Chaque requête contourne le cache, puisque le CDN envoie max-age=300 et qu'un cache de cinq minutes annulerait l'intérêt de l'outil.

J'en avais assez de consulter les sites d'offres à la main chaque matin, alors j'ai construit quelque chose qui le fait sur planification. J'ai utilisé de l'aide de l'IA pour la plus grande partie de l'implémentation. Ce que j'ai fait moi-même, c'est décider comment les pièces s'emboîtent, écrire une courte spec pour chacune, et fixer le format JSON qu'elles se passent avant qu'il y ait du code. Ensuite j'ai relu ce qui revenait, je l'ai testé et j'ai corrigé ce qui n'allait pas. Pouvoir lire et déboguer ce code est la partie qui compte pour moi.

C'est en trois parties. Un dépôt privé contient la planification et mes filtres et lance la récupération. Un dépôt public ne contient que le JSON produit. Une page statique lit ce JSON directement depuis le navigateur. Il n'y a de serveur nulle part là-dedans, ce qui le garde gratuit à faire tourner et fait qu'il n'y a rien à maintenir en vie.

La panne que je n'avais pas anticipée, c'est un travail planifié qui s'arrête en douce. Il ne vous prévient pas. Il continue d'afficher ce qu'il a récupéré la dernière fois, ça a l'air parfaitement normal, et vous le remarquez une semaine plus tard. Donc chaque passage note maintenant quand il a tourné et quelles sources ont répondu, et la page affiche l'âge des données. J'ai aussi appris comment marchent les ETags en construisant l'étape de récupération : si un site n'a pas changé depuis la dernière fois, il répond 304 et il n'y a rien à télécharger ni à analyser.

containersentinelPID 1 · subreaper./appown process groupfork · execorphanadoptedreapeddocker stopSIGTERMkill(-pgid)still alive after 5s, then SIGKILLexit status: the child's own, or 128 + N
Process supervision inside a container: sentinel runs as PID 1, forks and execs the application into its own process group, forwards an incoming SIGTERM to that whole group and escalates to SIGKILL after five seconds, adopts and reaps orphaned descendants, and exits with the child's own status.

Linux et conteneurs

2026

sentinel

Un petit programme qui vit dans un conteneur Linux et s'assure que l'application s'arrête proprement quand on le lui demande, sans laisser de processus orphelins derrière.

Un conteneur a dix secondes pour s'arrêter avant d'être tué net. Une application qui ne traite jamais le signal d'arrêt passe les dix à l'ignorer, puis perd ce qu'elle avait en cours.

  • Traite le signal d'arrêt pour que le conteneur sorte en environ 3 ms. Laissé seul, le même programme l'ignore et se fait tuer au bout de 10 secondes.
  • Redémarre un enfant qui meurt, en attendant 1, 2, 4, 8 puis 16 secondes entre les tentatives, et compte les redémarrages et les plantages pour Prometheus.
  • 13 tests et 5 jobs de CI écrits. La CI démarre toute la pile Docker Compose et échoue si Prometheus ne collecte pas ou si Grafana n'a pas de tableau de bord.
  • C++17
  • Linux
  • Signaux POSIX
  • Docker Compose
  • Prometheus
  • Grafana
  • GitHub Actions
Ce que PID 1 vous coûte
Arrêt après SIGTERM
2,5 à 3,1 ms

Sept exécutions contre un worker supervisé par sentinel, chronométrées en attendant le processus. Le même worker seul était encore vivant à dix secondes et a dû être tué.

Enfant qui ignore SIGTERM
5,003 s

Même montage avec le worker qui ignore le signal exprès. Trois exécutions à moins d'1 ms d'écart. C'est le délai de cinq secondes qui fait son travail.

Suite de tests
13 sur 13

ctest sur une compilation release, 33 s. La CI lance build, test, shellcheck, docker et compose comme jobs séparés.

Je voulais comprendre ce qui se passe vraiment quand on demande à un conteneur de s'arrêter. Docker envoie SIGTERM et attend dix secondes avant de le tuer. Linux traite le premier processus d'un conteneur comme un cas spécial et ne lui livre pas un signal tant que ce processus n'a pas installé de gestionnaire, donc un programme assis à cette place passe les dix secondes à ignorer la demande puis meurt en plein travail. sentinel prend cette place, transmet le signal au vrai programme, et s'efface.

Le bogue sur lequel j'ai passé le plus de temps, c'est un intervalle entre le démarrage du processus enfant et l'installation des gestionnaires. Un signal d'arrêt arrivant dans cette fenêtre tuait sentinel et laissait l'enfant tourner dans la nature, ce qui est exactement ce que le programme existe pour éviter. Je l'ai connu un moment et j'ai laissé un TODO dessus avant de comprendre que bloquer ces deux signaux le temps du démarrage, puis les débloquer une fois les gestionnaires en place, referme la fenêtre.

Une bonne partie de ce projet, c'était lire des pages de manuel puis tester si j'avais bien compris. Ce qui m'est resté : mesurer est plus dur qu'il n'y paraît. Mon premier chiffre d'arrêt était dix fois trop élevé parce que je vérifiais dans une boucle et je lisais mon propre délai. Attendre le processus correctement a donné le vrai chiffre.

Autres projets

  • Tests de mutation en CI pour GraphHopper

    2025

    Une vérification ajoutée à la compilation d'un moteur de routage libre, qui mesure si ses tests attraperaient vraiment un bogue et fait échouer la compilation quand ça se dégrade.

    JavaPITMockitoMavenGitHub Actions
  • Réseau de neurones et étude d'hyperparamètres

    2026

    Un petit classificateur d'images écrit de zéro en NumPy, compressé à 55 Ko pour tourner dans votre navigateur sur cette page.

    PythonNumPyPyTorch

Compétences

Langages
  • Java
  • SQL
  • C++
  • Python
  • Bash
  • PHP
  • C
  • Zig

Utilisé dans: Tous les projets présentés ici, et le travail chez Crono Design

JVM et données
  • Java 17
  • Maven
  • JUnit et Mockito
  • Spring Boot
  • Spring Data JPA
  • API REST
  • Conception de schémas PostgreSQL

Utilisé dans: Ma Ville · Tests de mutation en CI

Fiabilité et exploitation
  • Arrêt gracieux
  • Politique de redémarrage
  • Manuels d'exploitation
  • Journalisation d'audit
  • Débogage d'incidents

Utilisé dans: sentinel · six mois comme seule personne technique chez Crono Design

CI/CD et déploiement
  • GitHub Actions
  • Pipelines multi-jobs
  • Barrières de fusion
  • Docker
  • Constructions multi-étages
  • Docker Compose
  • Nginx

Utilisé dans: sentinel · Tests de mutation en CI · Ma Ville

Observabilité
  • Métriques Prometheus
  • Format d'exposition texte
  • Compteurs et jauges
  • Règles d'alerte
  • Tableaux de bord Grafana

Utilisé dans: sentinel, dont la CI échoue si la pile ne scrute pas vraiment

Linux et systèmes
  • Processus et signaux
  • fork / exec / wait
  • Supervision de processus
  • Concurrence
  • Gestion manuelle de la mémoire

Utilisé dans: sentinel · Fedora au quotidien

Outils
  • Git
  • GDB
  • strace
  • CMake
  • ctest
  • Make

Utilisé dans: La refonte de Ma Ville · la compilation de sentinel

Distinctions

Bourse d'excellence du DIRO2024
Le département d'informatique de l'Université de Montréal l'a décernée pour le dossier académique.
Top 30 au CTF NorthSec2025
Mon équipe s'est classée dans les 30 premières sur environ 93 à la plus grande compétition de sécurité appliquée d'Amérique du Nord.

À propos

Montréal, QC

Depuis six mois, je suis la seule personne technique sur la présence web d'un client. Je gère l'hébergement, les déploiements et les mises en ligne de contenu. J'ai rédigé le manuel d'exploitation pour qu'il arrête de m'appeler pour les changements de routine. C'est du travail ingrat. J'ai appris sur la fiabilité plus qu'avec tout ce que j'ai construit d'autre.

Les questions qui m'occupent sont celles auxquelles un cadriciel ne répond pas à votre place. De quoi le premier processus d'un conteneur est-il vraiment responsable ? Pourquoi une suite de tests peut-elle être verte et rater de vrais bogues ? Je choisis souvent un projet parce que je veux le savoir, et j'apprends surtout de la partie qui se passe mal.

Prochaine étape

Ma Ville garde tout en mémoire, donc un redémarrage perd tout. La prochaine pièce est Postgres derrière ce magasin.

Contact

Ce sur quoi j'aimerais travailler

Du back-end, surtout : des services Java et les données derrière, des conteneurs et du déploiement, des chaînes de compilation. Je suis surtout content dans une équipe où je peux poser des questions et voir comment des gens plus expérimentés que moi abordent un problème.

tarik.hireche@umontreal.ca
CV
PDF